取り込む。
PDF、Office、CSV、メール、DXF 図面、スキャンを、ファイル共有、S3、URL から。
PDF、スキャン、図面をそのまま投入してください。indx はすべてのページを確認して読み方を決め、ページと章節を保ったままの段落、表、図を検索とエージェントに渡します。パーサーを選ぶ必要はありません。
エージェントは、文の半分からは答えられません。必要なのは条項の全体、それが指す表の行、そして検査の前にある工程です。
高価な処理が動く前に、indx は各ページを走査し、必要な読み手を選びます。テキスト層があればテキスト層を、スキャンなら OCR を、図を認識すれば図のパーサーを。ファイルごとの設定は要りません。
native-extractionスキャン、読み手は generic-ocr図を認識 process-chart-parserindx が受け取った3つのページです。それぞれに、indx がどう読むと決めたかが表示されます。ページ上のブロックにカーソルを合わせると、そのブロックについて AI が受け取る出力が表示されます。
表では、セルひとつひとつが対象になります。図では、記号や接続線に合わせてから、出力側のリストも試してください。
native-extractionフォールバック generic-ocr → generic-vlm → manual-review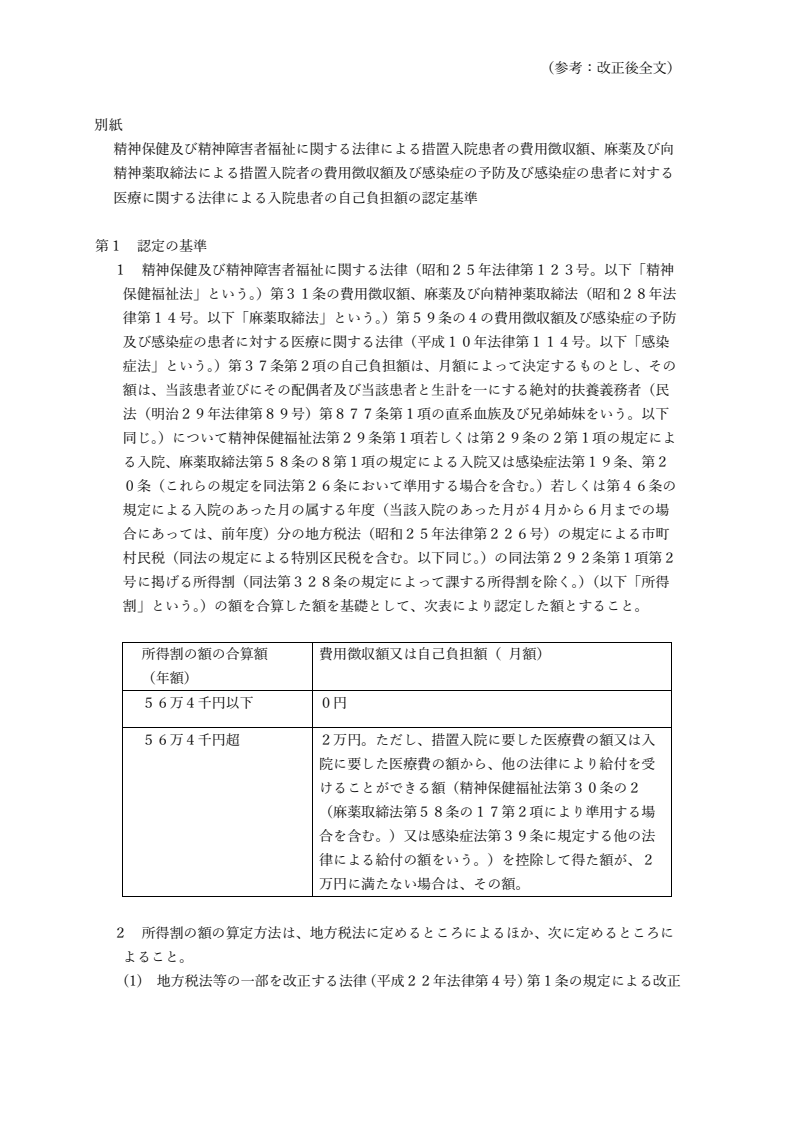
1 精神保健及び精神障害者福祉に関する法律(昭和25年法律第123号。以下「精神保健福祉法」という。)第31条の費用徴収額、麻薬及び向精神薬取締法(昭和28年法律第14号。以下「麻薬取締法」という。)第59条の4の費用徴収額及び感染症の予防及び感染症の患者に対する医療に関する法律(平成10年法律第114号。以下「感染症法」という。)第37条第2項の自己負担額は、月額によって決定するものとし、その額は、当該患者並びにその配偶者及び当該患者と生計を一にする絶対的扶養義務者(民法(明治29年法律第89号)第877条第1項の直系血族及び兄弟姉妹をいう。以下同じ。)について精神保健福祉法第29条第1項若しくは第29条の2第1項の規定による入院、麻薬取締法第58条の8第1項の規定による入院又は感染症法第19条、第20条(これらの規定を同法第26条において準用する場合を含む。)若しくは第46条の規定による入院のあった月の属する年度(当該入院のあった月が4月から6月までの場合にあっては、前年度)分の地方税法(昭和25年法律第226号)の規定による市町村民税(同法の規定による特別区民税を含む。以下同じ。)の同法第292条第1項第2号に掲げる所得割(同法第328条の規定によって課する所得割を除く。)(以下「所得割」という。)の額を合算した額を基礎として、次表により認定した額とすること。
{
  "id": "page:22/p22-para-1",
  "kind": "paragraph",
  "page": 22,
  "bbox": [0.14, 0.227, 0.858, 0.551],
  "section": [
    "別紙",
    "第1 認定の基準",
    "1"
  ],
  "text": "1 精神保健及び精神障害者福祉に関する法律(昭和25年法律第123号。以下「精神保健福祉法」という。)第31条の費用徴収額、麻薬及び向精神薬取締法(昭和28年法律第14号。以下「麻薬取締法」という。)第59条の4の費用徴収額及び感染症の予防及び感染症の患者に対する医療に関する法律(平成10年法律第114号。以下「感染症法」という。)第37条第2項の自己負担額は、月額によって決定するものとし、その額は、当該患者並びにその配偶者及び当該患者と生計を一にする絶対的扶養義務者(民法(明治29年法律第89号)第877条第1項の直系血族及び兄弟姉妹をいう。以下同じ。)について精神保健福祉法第29条第1項若しくは第29条の2第1項の規定による入院、麻薬取締法第58条の8第1項の規定による入院又は感染症法第19条、第20条(これらの規定を同法第26条において準用する場合を含む。)若しくは第46条の規定による入院のあった月の属する年度(当該入院のあった月が4月から6月までの場合にあっては、前年度)分の地方税法(昭和25年法律第226号)の規定による市町村民税(同法の規定による特別区民税を含む。以下同じ。)の同法第292条第1項第2号に掲げる所得割(同法第328条の規定によって課する所得割を除く。)(以下「所得割」という。)の額を合算した額を基礎として、次表により認定した額とすること。",
  "defined_terms": [
    {
      "term": "精神保健福祉法",
      "means": "精神保健及び精神障害者福祉に関する法律(昭和25年法律第123号)"
    },
    {
      "term": "麻薬取締法",
      "means": "麻薬及び向精神薬取締法(昭和28年法律第14号)"
    },
    {
      "term": "感染症法",
      "means": "感染症の予防及び感染症の患者に対する医療に関する法律(平成10年法律第114号)"
    },
    {
      "term": "所得割",
      "means": "地方税法第292条第1項第2号の所得割"
    }
  ],
  "references": [
    {
      "text": "次表",
      "target": "p22-table"
    }
  ],
  "provenance": {
    "reader": "native-extraction",
    "device": "cpu"
  }
}generic-ocrフォールバック generic-vlm → manual-review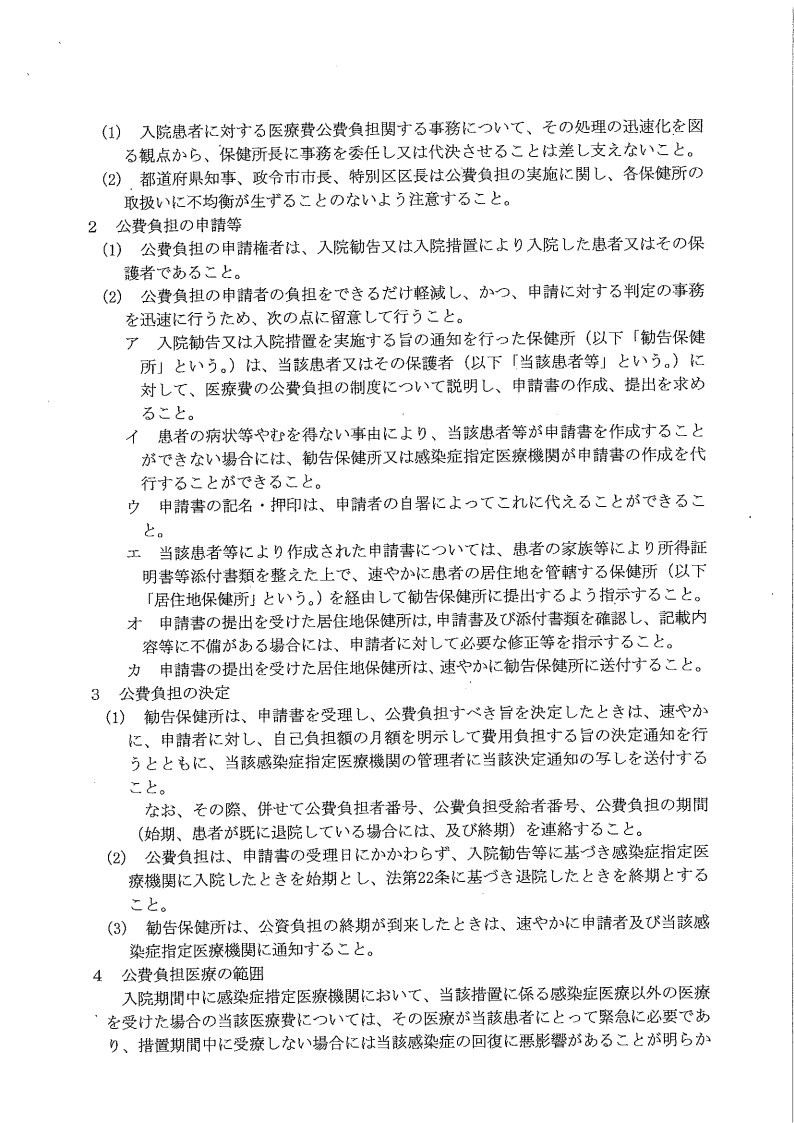
イ 患者の病状等やむを得ない事由により、当該患者等が申請書を作成することができない場合には、勧告保健所又は感染症指定医療機関が申請書の作成を代行することができること。
{
  "id": "page:5/p5-i",
  "kind": "paragraph",
  "page": 5,
  "bbox": [0.148, 0.372, 0.899, 0.44],
  "section": [
    "…",
    "2 公費負担の申請等",
    "(2)",
    "イ"
  ],
  "text": "イ 患者の病状等やむを得ない事由により、当該患者等が申請書を作成することができない場合には、勧告保健所又は感染症指定医療機関が申請書の作成を代行することができること。",
  "references": [
    {
      "text": "勧告保健所",
      "target": "p5-a"
    },
    {
      "text": "当該患者等",
      "target": "p5-a"
    }
  ],
  "provenance": {
    "reader": "generic-ocr",
    "device": "cpu",
    "ocr": {
      "lines": 3
    }
  }
}indx は読む前にすべてのページを確認し、渡すものには文書そのものの形を残します。
PDF、Office、CSV、メール、DXF 図面、スキャンを、ファイル共有、S3、URL から。
軽量な事前検査が、ページごとに読み手を選びます。テキスト層、OCR、図面パーサー。
行は段落に、セルは表に、図形と接続線は図にまとめます。
章節、定義語、相互参照、エンティティ、埋め込み。
すべてのブロックにページ、ボックス、章節、読み手を持つ JSON。検索とエージェントのために。
お客様の AWS、Azure、Google Cloud アカウントにデプロイします。ホスト型モデルを有効にしない限り、文書が外に出ることはありません。
ページ、ボックス、章節、そしてそれを生成した読み手。答えはいつでもページの上で確かめられます。
テキスト層、OCR、図面、埋め込みは CPU で動作します。最初のヒアリングから導入まで、エンジニアが伴走します。
文書を持ち込み、結果にカーソルを合わせる。